A pergunta chega quase sempre no mesmo formato: quanto de RAM e CPU o n8n precisa?
A resposta honesta é que a pergunta não tem resposta útil sem uma informação que só você tem. Duas instâncias com o mesmo número de fluxos podem exigir servidores completamente diferentes — porque o consumo do n8n é definido pelo que os fluxos fazem, não por quantos existem.
Um fluxo que move três campos de um formulário para uma planilha é irrelevante em termos de recursos. Um fluxo que baixa arquivos, processa imagens ou manipula grandes volumes de JSON pode consumir mais memória sozinho do que cinquenta fluxos leves somados.
Este guia mostra como dimensionar a partir dos seus próprios dados, quando a instância única deixa de bastar e como decidir entre adicionar recursos ou mudar de arquitetura.
O que realmente consome recursos
Quatro fatores governam o consumo, em ordem de impacto:
1. Volume de dados por execução
É o fator dominante. O n8n carrega em memória os dados que passam entre os nós de um fluxo. Um fluxo que processa dez registros e um que processa dez mil registros usam o mesmo código e consomem memória em ordens de grandeza diferentes.
Atenção especial a fluxos que baixam arquivos, manipulam imagens, leem planilhas grandes ou recebem respostas volumosas de APIs. São eles que definem o pico de memória da instância.
2. Execuções simultâneas
Fluxos disparados por webhook podem chegar em rajada. Fluxos agendados no mesmo minuto competem entre si. O que importa não é o total diário de execuções, e sim quantas acontecem ao mesmo tempo no pior momento.
3. Duração das execuções
Um fluxo que espera a resposta de uma API lenta ocupa a instância enquanto espera, mesmo sem consumir processamento. Fluxos longos reduzem a capacidade de atender outros ao mesmo tempo.
4. O banco de dados
Cada execução gera registros. O histórico cresce continuamente e, sem política de retenção, degrada a interface, as consultas e, no limite, enche o disco — o problema mais comum em instâncias que “pararam do nada”, como já tratamos no guia sobre como hospedar o n8n em servidor próprio.
Como medir o que você tem
Antes de escolher qualquer configuração, colete estes números — todos disponíveis na sua instância atual ou em um ambiente de teste:
- Execuções por hora no pico, e não a média diária.
- Execuções simultâneas no pior momento, observando o comportamento em horários de rajada.
- Duração média e máxima por fluxo, com atenção aos mais lentos.
- Memória consumida pelos fluxos mais pesados, executando-os isoladamente e observando o pico.
- Tamanho atual do banco e a taxa de crescimento semanal.
- Consumo de CPU e memória do servidor durante o horário de maior atividade.
Com esses seis números, a conversa com qualquer fornecedor muda: você deixa de perguntar “qual plano vocês recomendam” e passa a perguntar “esta configuração comporta esta carga”.
Se a instância ainda não existe, o caminho é montar um ambiente de teste e executar os fluxos reais — com volumes reais de dados. Estimar sem executar produz erro nos dois sentidos.
Por que não publicamos uma tabela de RAM por número de fluxos
Essa tabela existe em vários lugares e é a origem de boa parte dos dimensionamentos errados.
Uma instância com 200 fluxos simples de notificação e uma instância com 20 fluxos de processamento de arquivos aparecem na mesma linha de qualquer tabela por quantidade — e precisam de servidores incomparáveis.
O que substitui a tabela é o método: memória dimensionada pelo pico dos fluxos mais pesados executando simultaneamente, mais a reserva do banco de dados, mais a folga do sistema. Processamento dimensionado pelo perfil das execuções — leve para fluxos que esperam APIs, relevante para fluxos que transformam dados.
O primeiro sinal de que a instância única não basta
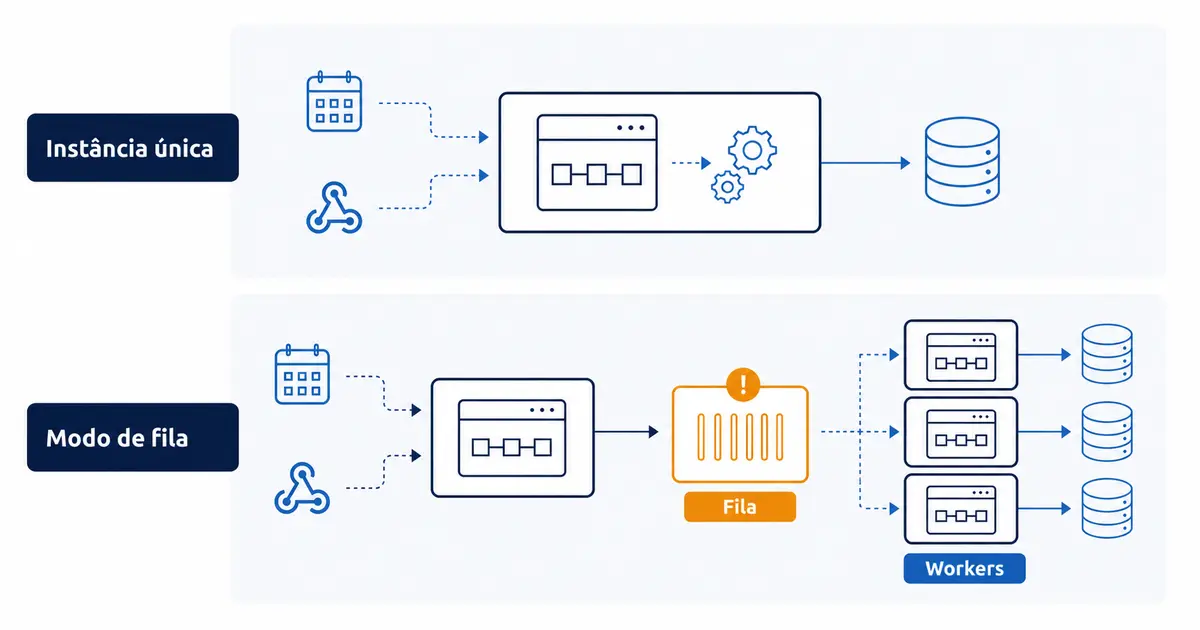
Uma instância padrão do n8n executa tudo em um processo só: interface, agendamentos, webhooks e execuções. Isso funciona bem até certo ponto, e o ponto tem sintomas reconhecíveis:
- A interface fica lenta ou trava enquanto fluxos pesados executam.
- Webhooks começam a demorar ou falham em momentos de rajada.
- Execuções ficam enfileiradas, com atraso perceptível entre o disparo e o início.
- Fluxos longos bloqueiam a execução de outros.
- A memória do servidor chega ao limite em picos, com processos sendo encerrados pelo sistema.
O último sintoma é o mais grave e o mais confuso de diagnosticar: quando a memória esgota, o sistema operacional encerra processos, e o resultado são falhas intermitentes sem padrão aparente.
Modo de fila: quando e o que muda
A resposta do n8n para escala é o modo de fila, e vale entender a arquitetura antes de decidir adotá-la.
Conforme a documentação oficial, nesse modo a instância principal deixa de executar os fluxos. Ela passa a cuidar dos disparos — agendamentos e webhooks — e coloca as execuções em uma fila gerenciada pelo Redis. Processos separados, os workers, retiram as execuções da fila, buscam as informações no banco e executam o trabalho, gravando o resultado ao final.
O que isso resolve:
- A interface deixa de competir com as execuções, porque o processo principal não executa fluxos.
- A capacidade passa a ser ajustável: adicionar ou remover workers muda a capacidade sem alterar os fluxos.
- Rajadas são absorvidas pela fila em vez de derrubar a instância.
O que ele exige:
- PostgreSQL obrigatoriamente. A documentação é explícita: o modo de fila não funciona com SQLite. Se a instalação começou em SQLite, migrar vem antes.
- Redis, como intermediário da fila.
- A mesma chave de criptografia em todos os processos — principal e workers. É um erro de configuração comum e ele quebra o acesso às credenciais.
- Mais componentes para operar e monitorar, o que aumenta a complexidade do ambiente.
Há ainda uma camada opcional adicional: processos dedicados a receber webhooks, com um balanceador distribuindo as requisições entre eles. A documentação recomenda não incluir o processo principal nesse balanceamento. Essa camada só se justifica em volumes altos de chamadas externas.
Workers ou concorrência: a decisão que confunde
Adotado o modo de fila, surge uma escolha que define o comportamento sob carga: cada worker pode executar vários fluxos em paralelo, e esse número é configurável.
A pergunta prática é: aumentar a concorrência de cada worker ou adicionar mais workers? O que responde é qual recurso está saturando.
| Sintoma observado | Ação indicada |
|---|---|
| Fila cresce, CPU folgada | Aumentar a concorrência por worker |
| CPU alta e fila crescendo | Adicionar workers |
| Memória no limite | Reduzir a concorrência e adicionar workers |
| Banco lento sob carga | Ajustar o banco antes de escalar workers |
A lógica: concorrência alta aproveita melhor a espera — fluxos que aguardam respostas de APIs. Workers adicionais distribuem processamento e memória. Aumentar a concorrência em fluxos que consomem muita memória é a receita mais direta para esgotar o servidor.
O ajuste correto se encontra por observação, não por cálculo: aumente aos poucos e acompanhe fila, CPU e memória até chegar ao ponto em que a fila permanece curta e os recursos ficam altos sem saturar.
O que monitorar
Sem esses indicadores, qualquer ajuste é adivinhação:
- Profundidade da fila — se ela cresce continuamente nos picos, a capacidade é insuficiente.
- Memória e CPU por processo, e não apenas do servidor.
- Duração das execuções, para identificar fluxos que degradaram.
- Taxa de erro por fluxo, que revela problemas antes de virarem incidente.
- Tamanho e crescimento do banco, com a política de retenção ativa.
- Espaço em disco, com alerta antes do limite.
Vale lembrar o ponto que torna monitoramento mais crítico aqui do que em um site: automação falha em silêncio. Ninguém reclama de um fluxo que deixou de rodar.
Um roteiro de dimensionamento
- Meça os seis números da seção inicial.
- Identifique o fluxo mais pesado e dimensione a memória pelo pico dele, considerando quantos podem executar ao mesmo tempo.
- Reserve a parte do banco separadamente, e considere separá-lo em outro servidor se o volume for alto.
- Some a folga do sistema operacional.
- Configure a retenção de execuções desde o início — ela muda o dimensionamento de disco de forma decisiva.
- Comece em instância única se os sintomas de saturação não apareceram. Modo de fila adiciona componentes e operação.
- Valide sob carga real antes de considerar a conta fechada.
Conclusão
Dimensionar um servidor para n8n é uma conta que parte dos seus fluxos, não de uma tabela genérica. Volume de dados por execução, execuções simultâneas no pico, duração e crescimento do banco são as quatro variáveis — e todas são mensuráveis na instância que você já tem.
O modo de fila é a resposta certa quando os sintomas de saturação aparecem, e desnecessário antes disso: ele adiciona PostgreSQL, Redis, workers e uma camada de operação que só se paga com volume real.
Se você já mediu a carga dos seus fluxos e quer validar a configuração, conheça o Cloud Server para n8n da TBF Host e compare as opções com os números que você levantou.
Perguntas frequentes
Quanto de RAM o n8n precisa?
Depende do que os fluxos fazem, não de quantos existem. A memória deve comportar o pico dos fluxos mais pesados executando simultaneamente, mais a reserva do banco de dados e a folga do sistema. Fluxos que baixam arquivos, processam imagens ou manipulam grandes volumes de dados definem esse pico.
O que mais consome recursos em uma instância de n8n?
O volume de dados que passa entre os nós de cada execução, que é o fator dominante; o número de execuções simultâneas no pico; a duração dos fluxos, já que os longos ocupam a instância enquanto esperam; e o crescimento do banco de dados, que sem política de retenção degrada a instância inteira.
O que é o modo de fila do n8n?
É a arquitetura de escala da ferramenta. A instância principal deixa de executar fluxos e passa a cuidar apenas dos disparos, colocando as execuções em uma fila gerenciada pelo Redis. Processos separados, chamados workers, retiram as execuções da fila e as executam, gravando os resultados no banco.
Quando devo adotar o modo de fila?
Quando aparecem os sintomas de saturação: interface lenta durante execuções pesadas, webhooks demorando ou falhando em rajadas, execuções enfileirando com atraso perceptível, fluxos longos bloqueando outros ou memória chegando ao limite nos picos. Antes disso, ele adiciona complexidade sem contrapartida.
O modo de fila do n8n funciona com SQLite?
Não. A documentação oficial é explícita: o modo de fila exige PostgreSQL. Se a instalação começou em SQLite, a migração do banco precisa acontecer antes de adotar essa arquitetura — mais um motivo para escolher PostgreSQL desde o primeiro dia em qualquer instância de produção.
É melhor aumentar a concorrência ou adicionar mais workers?
Depende de qual recurso está saturando. Se a fila cresce com CPU folgada, aumentar a concorrência por worker aproveita melhor os fluxos que ficam esperando respostas de APIs. Se a CPU está alta, adicionar workers distribui o processamento. Se a memória está no limite, o caminho é reduzir a concorrência e adicionar workers.
Preciso de Redis para rodar o n8n?
Apenas no modo de fila, onde ele atua como intermediário entre a instância principal e os workers. Em uma instalação de instância única, o Redis não é necessário. Ele passa a ser um componente obrigatório quando a arquitetura muda para suportar execução distribuída.
Por que minha instância de n8n falha de forma intermitente?
Uma causa frequente é o esgotamento de memória nos picos: quando ela acaba, o sistema operacional encerra processos, produzindo falhas sem padrão aparente. Outra é o crescimento do banco de dados sem política de retenção, que degrada consultas e pode encher o disco, derrubando aplicação e banco juntos.